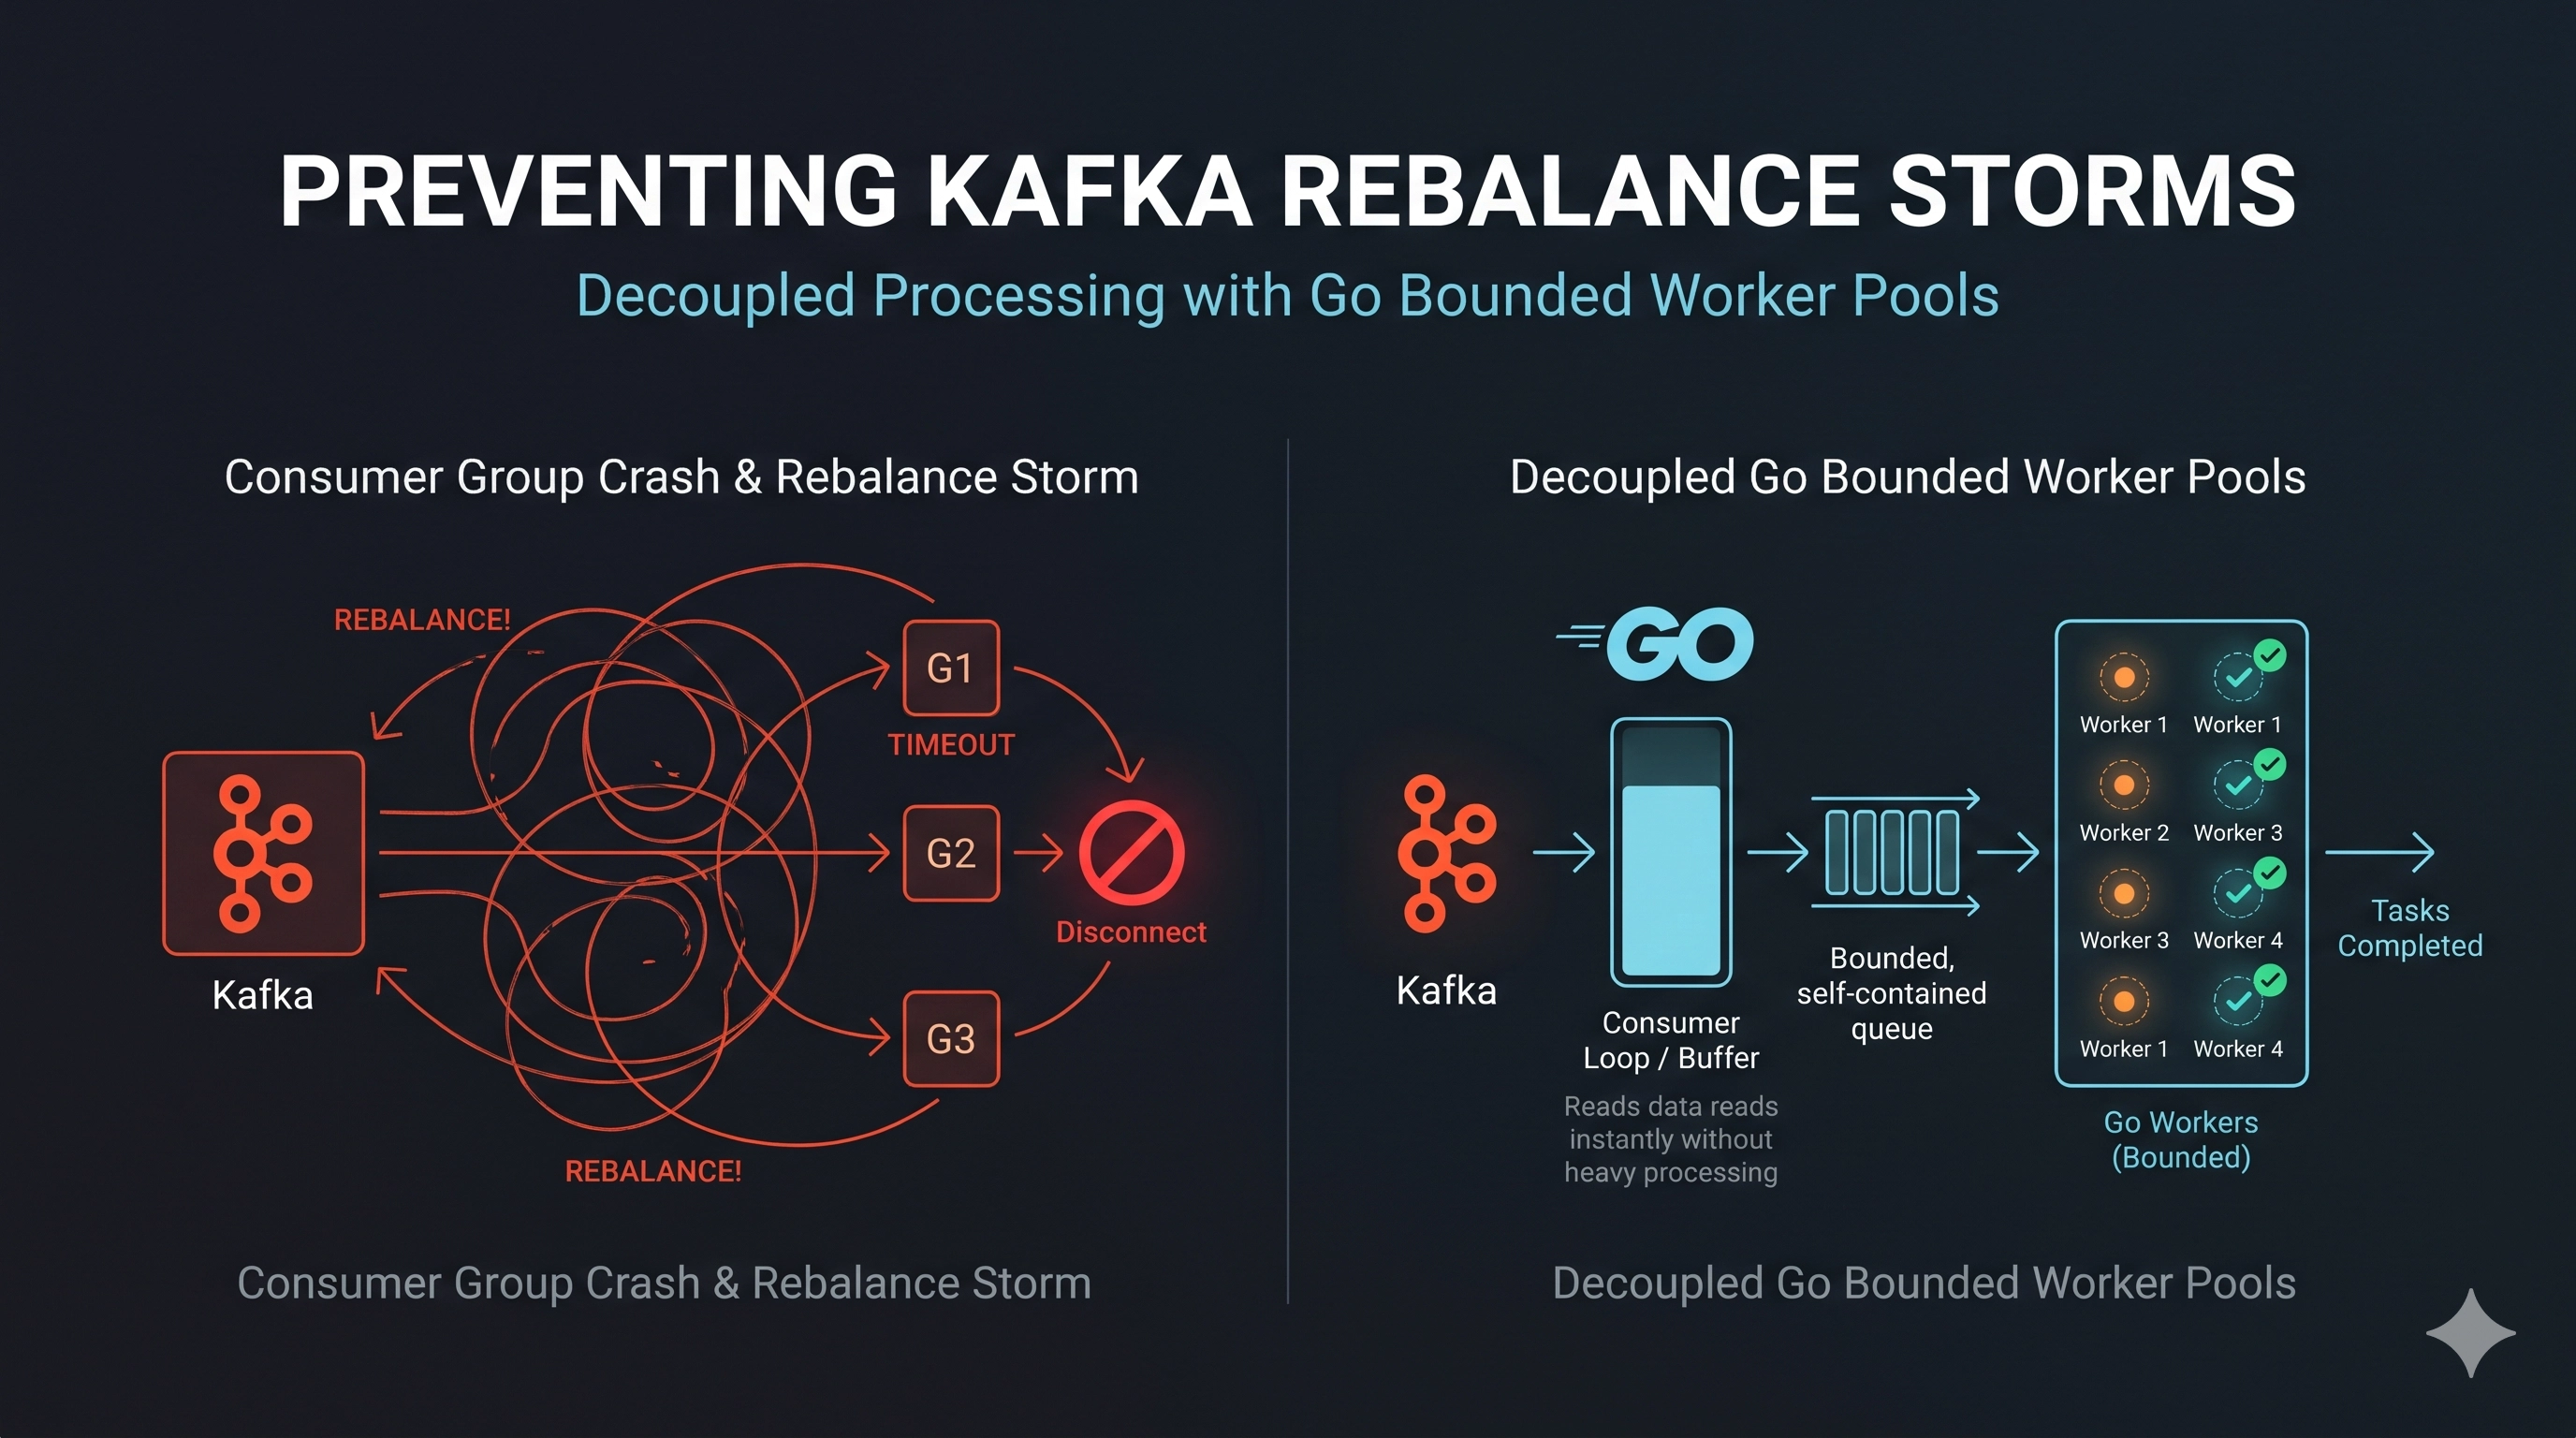
Giải Phẫu Một Rebalance Storm Trong Apache Kafka
Trong các consumer group của Apache Kafka, sự ổn định dựa trên một cam kết chặt chẽ giữa Group Coordinator trên broker và các consumer client. Nếu một consumer không gửi heartbeat trong khoảng thời gian session.timeout.ms, hoặc không gọi hàm Poll() trong max.poll.interval.ms, coordinator sẽ coi node đó đã chết. Broker lập tức thu hồi các partition được phân công và kích hoạt quá trình rebalance group.
Trong các ứng dụng microservices xử lý tải lớn hoặc phải thực hiện I/O qua mạng (như ghi vào PostgreSQL hoặc gọi API của bên thứ ba), độ trễ đột ngột có thể khiến thời gian xử lý một batch vượt quá max.poll.interval.ms. Khi điều này xảy ra, một chuỗi phản ứng dây chuyền mang tính hủy diệt gọi là Rebalance Storm sẽ bùng nổ:
- Consumer A lấy một batch thông điệp. Việc xử lý bị nghẽn do truy vấn CSDL chậm hoặc API đối tác bị giới hạn tốc độ (rate limit).
- Hạn định
max.poll.interval.mshết hiệu lực. Consumer A bị loại khỏi group, kích hoạt rebalance. - Kafka thu hồi partition của Consumer A và giao lại cho Consumer B.
- Consumer B cố gắng xử lý lại đúng batch thông điệp chưa được commit đó, tiếp tục bị nghẽn và cũng hết thời gian chờ (timeout).
- Toàn bộ cluster rơi vào vòng lặp rebalance liên tục, khiến băng thông xử lý của toàn hệ thống giảm về số 0.
Kiến Trúc: Tách Biệt Polling Hoàn Toàn Khỏi Execution
Điểm yếu cốt lõi trong vòng lặp consumer mặc định của Kafka là sự gắn kết chặt chẽ (tight coupling) giữa việc lấy dữ liệu (polling) và thực thi logic nghiệp vụ. Để ngăn chặn hoàn toàn rebalance storm, chúng ta phải tách biệt hoàn toàn luồng polling khỏi luồng xử lý dữ liệu.
Tuy nhiên, việc thực thi bất đồng bộ đơn thuần sẽ dẫn đến hai rủi ro lớn:
- Vi Phạm Thứ Tự Dữ Liệu: Xử lý đồng thời các bản ghi từ cùng một partition mà không kiểm soát thứ tự sẽ làm sai lệch trạng thái hệ thống.
- Tràn Bộ Nhớ (Unbounded Memory Growth): Việc tạo goroutine vô hạn cho mỗi message mà không có cơ chế kiểm soát áp lực ngược (backpressure) sẽ làm kiệt hỏng bộ nhớ RAM khi hệ thống phía sau gặp sự cố.
Giải pháp tối ưu là sử dụng Bounded Worker Pool theo Partition Key kết hợp với cơ chế backpressure động thông qua tính năng tạm dừng nhận dữ liệu của Kafka (Pause() / Resume()).
Triển Khai Worker Pool Hạn Chế Trong Go
Dưới đây là mô hình triển khai chuẩn production trong Go. Chúng ta khởi tạo một số lượng kênh (channel) cố định cho các worker. Các thông điệp thuộc cùng một partition (hoặc cùng partition key) sẽ được điều hướng chính xác vào cùng một worker goroutine, đảm bảo tính thứ tự tuyệt đối trên mỗi key trong khi vẫn đạt được hiệu năng xử lý song song cao giữa các partition khác nhau.
package main

import (
	"context"
	"fmt"
	"hash/fnv"
	"sync"
	"time"
)

type KafkaMessage struct {
	Topic     string
	Partition int32
	Offset    int64
	Key       []byte
	Value     []byte
}

type WorkerPool struct {
	workers    int
	jobChans   []chan KafkaMessage
	ctx        context.Context
	cancel     context.CancelFunc
	wg         sync.WaitGroup
	tracker    *OffsetTracker
}

func NewWorkerPool(workers int, bufferSize int, tracker *OffsetTracker) *WorkerPool {
	ctx, cancel := context.WithCancel(context.Background())
	pool := &WorkerPool{
		workers:  workers,
		jobChans: make([]chan KafkaMessage, workers),
		ctx:      ctx,
		cancel:   cancel,
		tracker:  tracker,
	}

	for i := 0; i < workers; i++ {
		pool.jobChans[i] = make(chan KafkaMessage, bufferSize)
		pool.wg.Add(1)
		go pool.workerLoop(i)
	}

	return pool
}

func (p *WorkerPool) workerLoop(workerID int) {
	defer p.wg.Done()
	for {
		select {
		case <-p.ctx.Done():
			return
		case msg, ok := <-p.jobChans[workerID]:
			if !ok {
				return
			}
			p.processMessage(msg)
		}
	}
}

func (p *WorkerPool) processMessage(msg KafkaMessage) {
	// Mô phỏng tác vụ I/O hoặc tính toán nặng
	time.Sleep(50 * time.Millisecond)

	// Đánh dấu thông điệp đã xử lý xong trong offset tracker
	p.tracker.MarkCompleted(msg.Topic, msg.Partition, msg.Offset)
}

func (p *WorkerPool) Submit(msg KafkaMessage) bool {
	// Hash partition key để đảm bảo phân phối nhất quán vào một worker
	h := fnv.New32a()
	h.Write([]byte(fmt.Sprintf("%s-%d-%s", msg.Topic, msg.Partition, string(msg.Key))))
	workerIdx := int(h.Sum32()) % p.workers

	select {
	case p.jobChans[workerIdx] <- msg:
		return true
	default:
		// Hàng chờ đã đầy; kích hoạt backpressure
		return false
	}
}

func (p *WorkerPool) Shutdown() {
	p.cancel()
	for _, ch := range p.jobChans {
		close(ch)
	}
	p.wg.Wait()
}
Quản Lý Offset Commit Khi Xử Lý Bất Đồng Bộ
Khi các thông điệp được xử lý bất đồng bộ trên nhiều worker, việc hoàn thành không theo đúng thứ tự offset ban đầu tạo ra rủi ro commit sai lệch. Nếu thông điệp ở offset 105 hoàn thành trước offset 102, việc commit offset 105 lên Kafka quá sớm sẽ dẫn đến mất dữ liệu nếu ứng dụng bị crash trước khi offset 102 xử lý xong.
Để giải quyết vấn đề này, chúng ta cần một cơ chế theo dõi sliding window liên tục. Một offset của partition chỉ được phép commit lên Kafka khi tất cả các offset đứng trước nó trong cùng partition đã hoàn tất thành công.
type PartitionState struct {
	sync.Mutex
	completedOffsets map[int64]bool
	lastCommitted    int64
}

type OffsetTracker struct {
	sync.RWMutex
	partitions map[string]*PartitionState
}

func NewOffsetTracker() *OffsetTracker {
	return &OffsetTracker{
		partitions: make(map[string]*PartitionState),
	}
}

func (t *OffsetTracker) MarkCompleted(topic string, partition int32, offset int64) {
	key := fmt.Sprintf("%s-%d", topic, partition)

	t.Lock()
	state, exists := t.partitions[key]
	if !exists {
		state = &PartitionState{
			completedOffsets: make(map[int64]bool),
			lastCommitted:    -1,
		}
		t.partitions[key] = state
	}
	t.Unlock()

	state.Lock()
	defer state.Unlock()
	state.completedOffsets[offset] = true
}

func (t *OffsetTracker) GetSafeCommitOffset(topic string, partition int32, currentFetchHead int64) int64 {
	key := fmt.Sprintf("%s-%d", topic, partition)

	t.RLock()
	state, exists := t.partitions[key]
	t.RUnlock()

	if !exists {
		return -1
	}

	state.Lock()
	defer state.Unlock()

	safeOffset := state.lastCommitted
	for check := state.lastCommitted + 1; check <= currentFetchHead; check++ {
		if state.completedOffsets[check] {
			safeOffset = check
			delete(state.completedOffsets, check)
		} else {
			// Phát hiện khoảng trống (gap)! Không thể commit vượt qua offset chưa hoàn tất này.
			break
		}
	}

	state.lastCommitted = safeOffset
	return safeOffset
}
Cấu Hình Production Và Xử Lý Trường Hợp Ngoại Lệ
Tách biệt polling khỏi execution giải quyết triệt để sự cố rebalance timeout, nhưng sẽ phát sinh các rủi ro mới nếu không quản lý tốt áp lực ngược. Dưới đây là các nguyên tắc quan trọng khi triển khai trên production:
- Tạm Dừng Lấy Dữ Liệu Khi Hàng Chờ Quá Tải: Khi các worker channel chạm mức 80% dung lượng, hãy gọi API
Pause()của consumer client cho các partition đó. Tiếp tục duy trì vòng lặpPoll()để gửi heartbeat đều đặn cho broker mà không lấy thêm message mới. GọiResume()khi dung lượng hàng chờ giảm xuống dưới 20%. - Điều Chỉnh max.poll.records: Không nên lấy hàng nghìn record trong một lần poll nếu đội ngũ worker của bạn không thể xử lý xong trong khoảng thời gian hợp lý. Hãy đặt
max.poll.recordsbằng một bội số nhỏ tương ứng với tổng sức chứa của worker pool. - Dọn Dẹp Xử Lý Khi Tắt Ứng Dụng (Graceful Shutdown): Khi nhận tín hiệu SIGTERM, hãy ngừng lấy thông điệp mới, kích hoạt việc xả sạch (drain) hàng chờ worker pool, chờ tất cả các offset đang xử lý dở hoàn tất trong
OffsetTracker, và thực hiện commit offset cuối cùng trước khi dừng ứng dụng.
Điểm Cốt Lõi
- Rebalance storm xuất hiện khi độ trễ xử lý dữ liệu đồng bộ vượt quá
max.poll.interval.ms, khiến broker coordinator loại bỏ các consumer đang hoạt động khỏi group. - Tách biệt vòng lặp Kafka polling khỏi luồng thực thi nghiệp vụ đảm bảo heartbeat luôn được gửi đúng giờ bất chấp độ trễ của hạ tầng phía sau.
- Kỹ thuật băm partition key trong worker pool giúp giữ nguyên tắc thứ tự xử lý dữ liệu trên từng partition key mà vẫn tối ưu khả năng xử lý song song.
- Tuyệt đối không commit trực tiếp offset khi xử lý bất đồng bộ out-of-order; hãy sử dụng bộ theo dõi sliding window để đảm bảo offset chỉ được commit khi toàn bộ thông điệp phía trước đã xử lý thành công.
Hãy là người đầu tiên bình luận.
Để lại bình luận