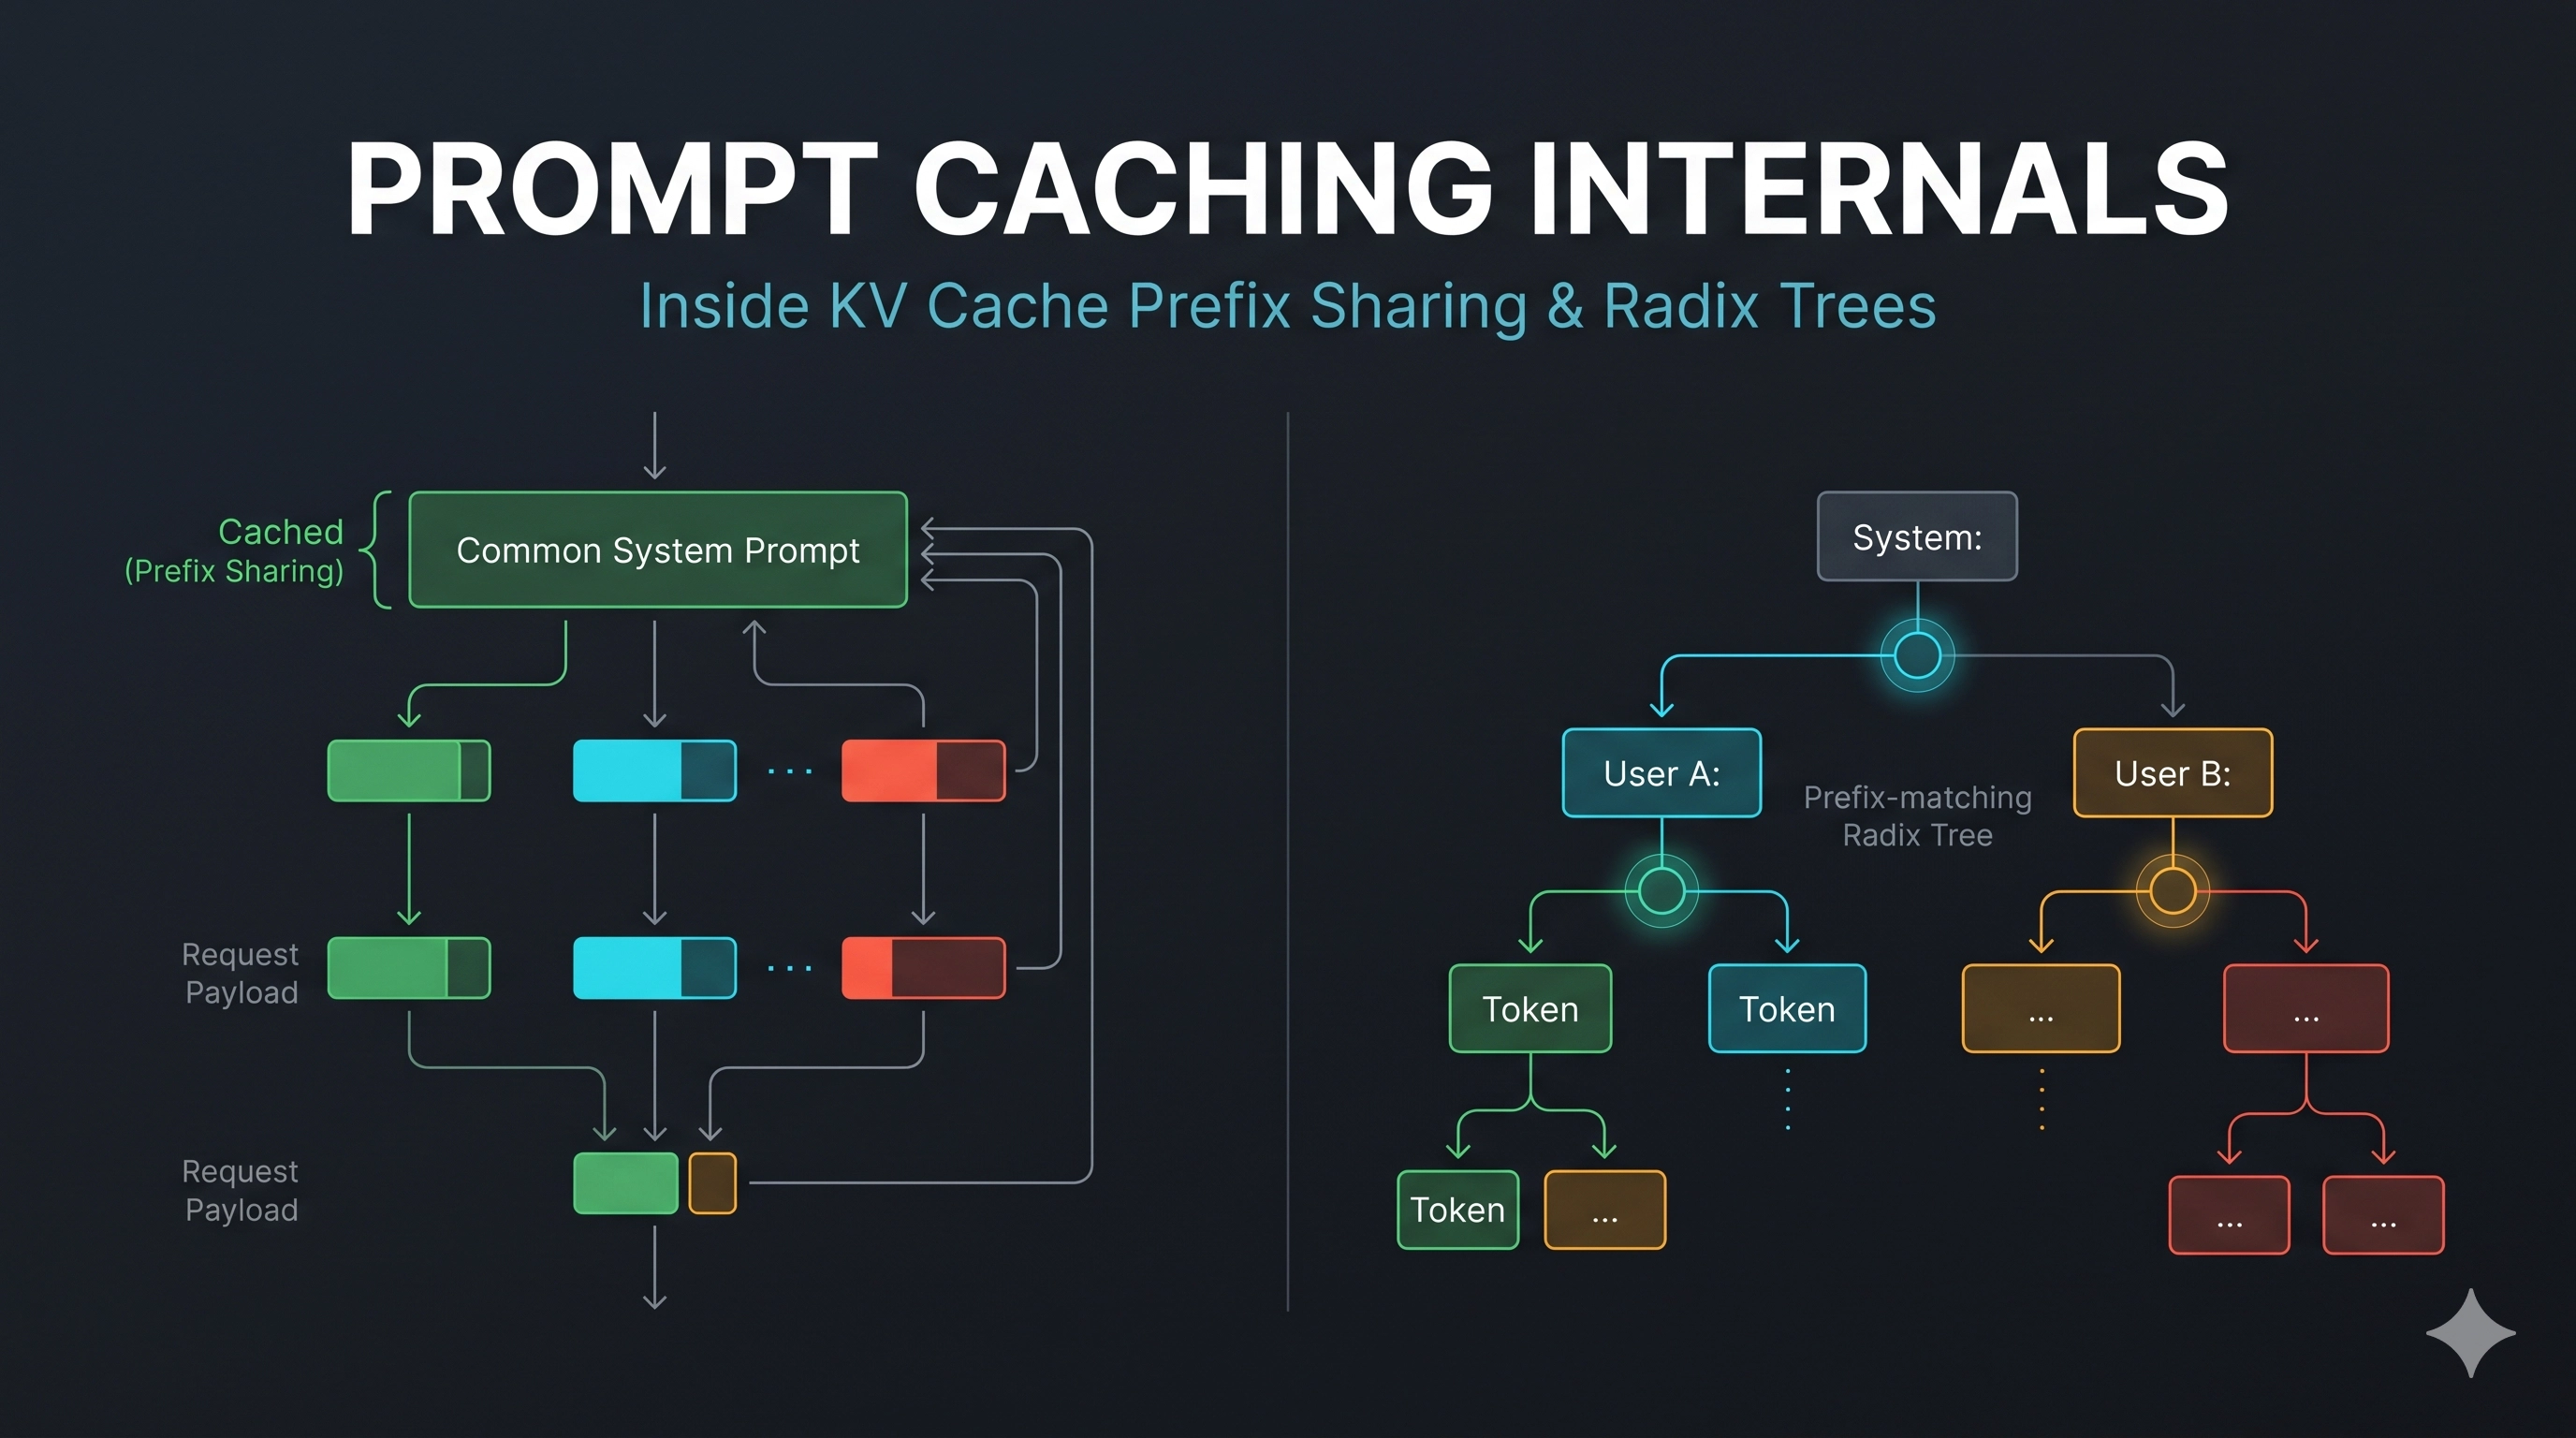
Rào Cản Độ Trễ: Vì Sao Pha Prefill Chi Phối Hệ Thống LLM
Trong các hệ thống phục vụ Large Language Model (LLM) thông lượng cao, độ trễ sinh từ được phân chia thành hai pha riêng biệt: prefill (xử lý song song các token đầu vào để tạo ma trận Key-Value ban đầu) và decode (sinh tuần tự từng token tiếp theo). Trong khi pha decode bị giới hạn bởi băng thông (bandwidth-bound) do tốc độ đọc trọng số mô hình từ High Bandwidth Memory (HBM), thì pha prefill lại thuần túy bị giới hạn bởi năng lực tính toán (compute-bound) với độ phức tạp $O(N^2)$ theo độ dài chuỗi trong cơ chế multi-head self-attention.
Xét trường hợp một agent tự hành hoặc chatbot trao đổi tài liệu qua nhiều lượt (multi-turn chat). Trong mỗi lượt tương tác, hệ thống gửi lại toàn bộ lịch sử hội thoại, hàng nghìn token chỉ dẫn hệ thống và định nghĩa công cụ bên ngoài. Việc tính toán lại toàn bộ pha prefill cho một prompt hệ thống 16.000 token giống hệt nhau trên mỗi request làm lãng phí nghiêm trọng FLOPs của GPU, khiến chỉ số Time-To-First-Token (TTFT) tăng vọt và làm nghẽn năng lực phục vụ đồng thời. Prompt caching giải quyết triệt để vấn đề này bằng cách giữ lại các tensor Key và Value đã tính toán trên VRAM của GPU giữa các request, biến phép nhân ma trận $O(N^2)$ thành thao tác tra cứu bộ nhớ $O(1)$.
Bản Chất KV Cache: Bố Cục Bộ Nhớ và PagedAttention
Để hiểu prompt caching, trước tiên cần phân tích cách các tensor KV cache tồn tại trong VRAM của GPU. Với một mô hình transformer tiêu chuẩn, mỗi layer chú ý (attention layer) lưu trữ các ma trận Key ($K$) và Value ($V$) cho từng token. Kích thước byte của KV cache cho một chuỗi ngữ cảnh được tính theo công thức:
Bytes = 2 * n_layers * n_kv_heads * d_head * precision_bytes * seq_lenVí dụ với Llama-3-70B (80 layers, 8 cặp KV head khi áp dụng Grouped-Query Attention, kích thước head 128, định dạng FP16):
Bytes_per_token = 2 * 80 * 8 * 128 * 2 = 327.680 bytes (~320 KB/token)Một ngữ cảnh dài 16.000 token chiếm khoảng 5,12 GB VRAM chỉ riêng cho dữ liệu KV. Trước đây, các engine suy luận cổ điển cấp phát các vùng nhớ liên tục theo độ dài ngữ cảnh tối đa ($L_{max}$), gây ra lãng phí bộ nhớ do phân mảnh nội vi (internal fragmentation) vượt quá 60%. Các hệ thống hiện đại như vLLM đã giải quyết vấn đề này bằng PagedAttention, lấy cảm hứng từ cơ chế phân trang bộ nhớ ảo của hệ điều hành. Thay vì cấp phát một vùng nhớ vật lý liên tục, KV cache được chia thành các block có kích thước cố định (thường là 16 hoặc 32 token). Địa chỉ block logic được ánh xạ động tới các trang vật lý rời rạc trên GPU thông qua bảng phân trang (block table).
Cơ Chế Prefix Caching: Radix Tree Đối Đầu Chunked Hash
Khi bộ nhớ KV đã được chia nhỏ thành các block vật lý độc lập, việc chia sẻ tiền tố giống nhau giữa các request trở thành bài toán ánh xạ địa chỉ. Hiện có hai trường phái kiến trúc chính trong sản xuất:
1. Chunked Boundary Hashing (API Thương Mại)
Các nhà cung cấp đóng như Anthropic hay OpenAI chia prompt thành các khối token có kích thước cố định (ví dụ: mỗi khối 1.024 token). Mỗi khối được băm bằng thuật toán băm (như xxHash64) nối tiếp từ giá trị băm của khối trước đó. Nếu prompt gửi đến khớp giá trị băm tiền tố đến mốc $k imes 1024$, engine tái sử dụng các block đã tính toán và chỉ chạy prefill cho phần đuôi còn lại.
2. Token-Level Radix Tree (vLLM, SGLang)
Các engine mã nguồn mở hiện đại triển khai một cây Radix (Radix Tree) trên RAM máy chủ để quản lý trực tiếp các block KV trên GPU. Khác với cơ chế băm kích thước cố định, cây Radix biểu diễn linh hoạt các chuỗi token thành các nhánh có độ dài tùy biến.
- Node đại diện cho một chuỗi token và lưu con trỏ trỏ tới các trang bộ nhớ KV vật lý trên GPU.
- Cạnh (Edge) biểu diễn bước chuyển dịch token.
- Bộ đếm tham chiếu (Reference Counter) theo dõi số lượng request đang đọc dữ liệu từ node đó.
- Hàng đợi giải phóng LRU ưu tiên thu hồi các node không còn tham chiếu khi VRAM chạm ngưỡng tới hạn.
Khi có một request mới với danh sách token $[t_0, t_1, ..., t_m]$, engine duyệt cây Radix từ node gốc để tìm tiền tố trùng khớp dài nhất. Nó lấy lại toàn bộ chỉ số block vật lý đã khớp, điền vào block table của request đó, và chỉ đẩy phần đuôi chưa khớp $[t_k, ..., t_m]$ vào các nhân tensor của GPU để tính toán.
Mô Phỏng Bộ Quản Lý Radix Cache Bằng Mã Lệnh
Dưới đây là đoạn mã Python mô phỏng cách bộ quản lý Radix Cache đánh chỉ mục các block token, theo dõi tham chiếu và trích xuất tiền tố có thể tái sử dụng:
import time
from typing import Dict, List, Optional, Tuple

class RadixNode:
    def __init__(self, token_ids: List[int], physical_blocks: List[int], parent: Optional['RadixNode'] = None):
        self.token_ids = token_ids
        self.physical_blocks = physical_blocks
        self.children: Dict[int, 'RadixNode'] = {}
        self.parent = parent
        self.ref_count = 0
        self.last_accessed = time.time()

class RadixKVCache:
    def __init__(self, block_size: int = 16):
        self.block_size = block_size
        self.root = RadixNode(token_ids=[], physical_blocks=[])

    def match_prefix(self, tokens: List[int]) -> Tuple[List[int], int]:
        """Duyệt cây Radix để tìm các block vật lý cho tiền tố dài nhất khớp với prompt."""
        node = self.root
        matched_blocks = []
        token_offset = 0

        while token_offset < len(tokens):
            first_token = tokens[token_offset]
            if first_token not in node.children:
                break

            child = node.children[first_token]
            edge_len = len(child.token_ids)
            segment = tokens[token_offset : token_offset + edge_len]

            # Kiểm tra xem đoạn token hiện tại có khớp toàn bộ cạnh hay không
            if segment == child.token_ids:
                matched_blocks.extend(child.physical_blocks)
                token_offset += edge_len
                node = child
                node.last_accessed = time.time()
            else:
                # Khớp một phần: tìm đoạn tiền tố chung
                match_len = 0
                for a, b in zip(segment, child.token_ids):
                    if a == b:
                        match_len += 1
                    else:
                        break

                # Tách cạnh nếu khớp tròn theo block_size
                usable_blocks = match_len // self.block_size
                matched_blocks.extend(child.physical_blocks[:usable_blocks])
                token_offset += usable_blocks * self.block_size
                break

        return matched_blocks, token_offset

    def pin_node(self, node: RadixNode):
        curr = node
        while curr:
            curr.ref_count += 1
            curr = curr.parent

    def unpin_node(self, node: RadixNode):
        curr = node
        while curr:
            curr.ref_count = max(0, curr.ref_count - 1)
            curr = curr.parent
Cơ Chế Giải Phóng Bộ Nhớ: LRU và Reference Counting
Do dung lượng VRAM của GPU là hữu hạn, cây Radix không thể phình to vô hạn. Khi engine không còn đủ block trống để cấp phát cho một request mới, bộ quản lý bộ nhớ sẽ kích hoạt chu trình giải phóng (eviction):
- Lọc node lá khả dụng: Quét các node lá trên cây có
ref_count == 0(nghĩa là không có request nào đang tính toán hoặc sinh token dựa trên nhánh này). - Cắt tỉa theo LRU: Các node có nhãn thời gian
last_accessedcũ nhất sẽ bị hủy. Các trang bộ nhớ GPU tương ứng được trả về danh sách trang tự do (free list). - Hợp nhất nhánh (Branch Consolidation): Nếu một node cha chỉ còn lại đúng một node con sau khi cắt tỉa, mảng token của cạnh sẽ được gộp lại để tối ưu hóa bộ nhớ RAM lưu trữ cây.
Cảnh Báo Lỗi: Nếu hệ thống đối mặt với tải đồng thời cực lớn cùng các tiền tố phân tán không đồng nhất, hiện tượng cache thrashing (đảo cache liên tục) sẽ xảy ra. Chi phí duyệt cây, giải phóng trang và phân mảnh bộ nhớ có thể khiến độ trễ tổng thể tệ hơn cả khi không dùng cache.
Các Cạm Bẫy Trong Thực Tế Vận Hành
Để tận dụng tối đa lợi thế giảm độ trễ và chi phí từ prompt caching, kỹ sư cần thiết kế cấu trúc prompt tuân thủ nghiêm ngặt các nguyên tắc:
- Đặt Tiền Tố Tĩnh Lên Đầu: Luôn đặt nội dung bất biến (system prompt, định nghĩa công cụ, schema JSON) ở phần đầu tuyệt đối của chuỗi token. Chỉ cần chèn một token động duy nhất (như timestamp hiện tại hoặc seed ngẫu nhiên) ở vị trí token số 0, toàn bộ cây cache phía sau sẽ bị vô hiệu hóa hoàn toàn.
- Căn Chỉnh Biên Độ Khối (Block Alignment): Với các API dùng cơ chế chunked hashing, hãy đảm bảo các tài liệu dài được căn chỉnh sát biên (ví dụ: bội số của 1.024 token). Một sự xê dịch nhỏ chỉ vài ký tự có thể đẩy toàn bộ văn bản phía sau sang ranh giới chunk mới, dẫn đến cache miss hàng loạt.
- Tuần Tự Hóa Dữ Liệu Xác Định (Deterministic Serialization): Các tham số của tool và JSON schema phải được serialize với khóa sắp xếp cố định (sorted keys). Khóa JSON sắp xếp khác thứ tự sẽ sinh ra dãy token ID khác nhau, tạo ra các nhánh rẽ riêng biệt trên cây Radix và làm nhân đôi lượng VRAM tiêu hao.
Điểm Cốt Lõi
- Prompt caching biến phép tính prefill nặng nề thành thao tác tra cứu bộ nhớ bằng cách lưu trữ các tensor Key-Value qua nhiều lần gọi API.
- Các runtime hiện đại áp dụng PagedAttention để triệt tiêu phân mảnh bộ nhớ và dùng cây Radix để chia sẻ linh hoạt tiền tố có độ dài bất kỳ.
- Mỗi node trong cây Radix ánh xạ trực tiếp dải token logic vào các trang GPU vật lý rời rạc và được điều phối bằng thuật toán giải phóng LRU.
- Mọi yếu tố bất định đặt ở đầu prompt (timestamp động, JSON schema không sắp xếp) đều sẽ phá vỡ hoàn toàn chuỗi cache phía sau.
Hãy là người đầu tiên bình luận.
Để lại bình luận