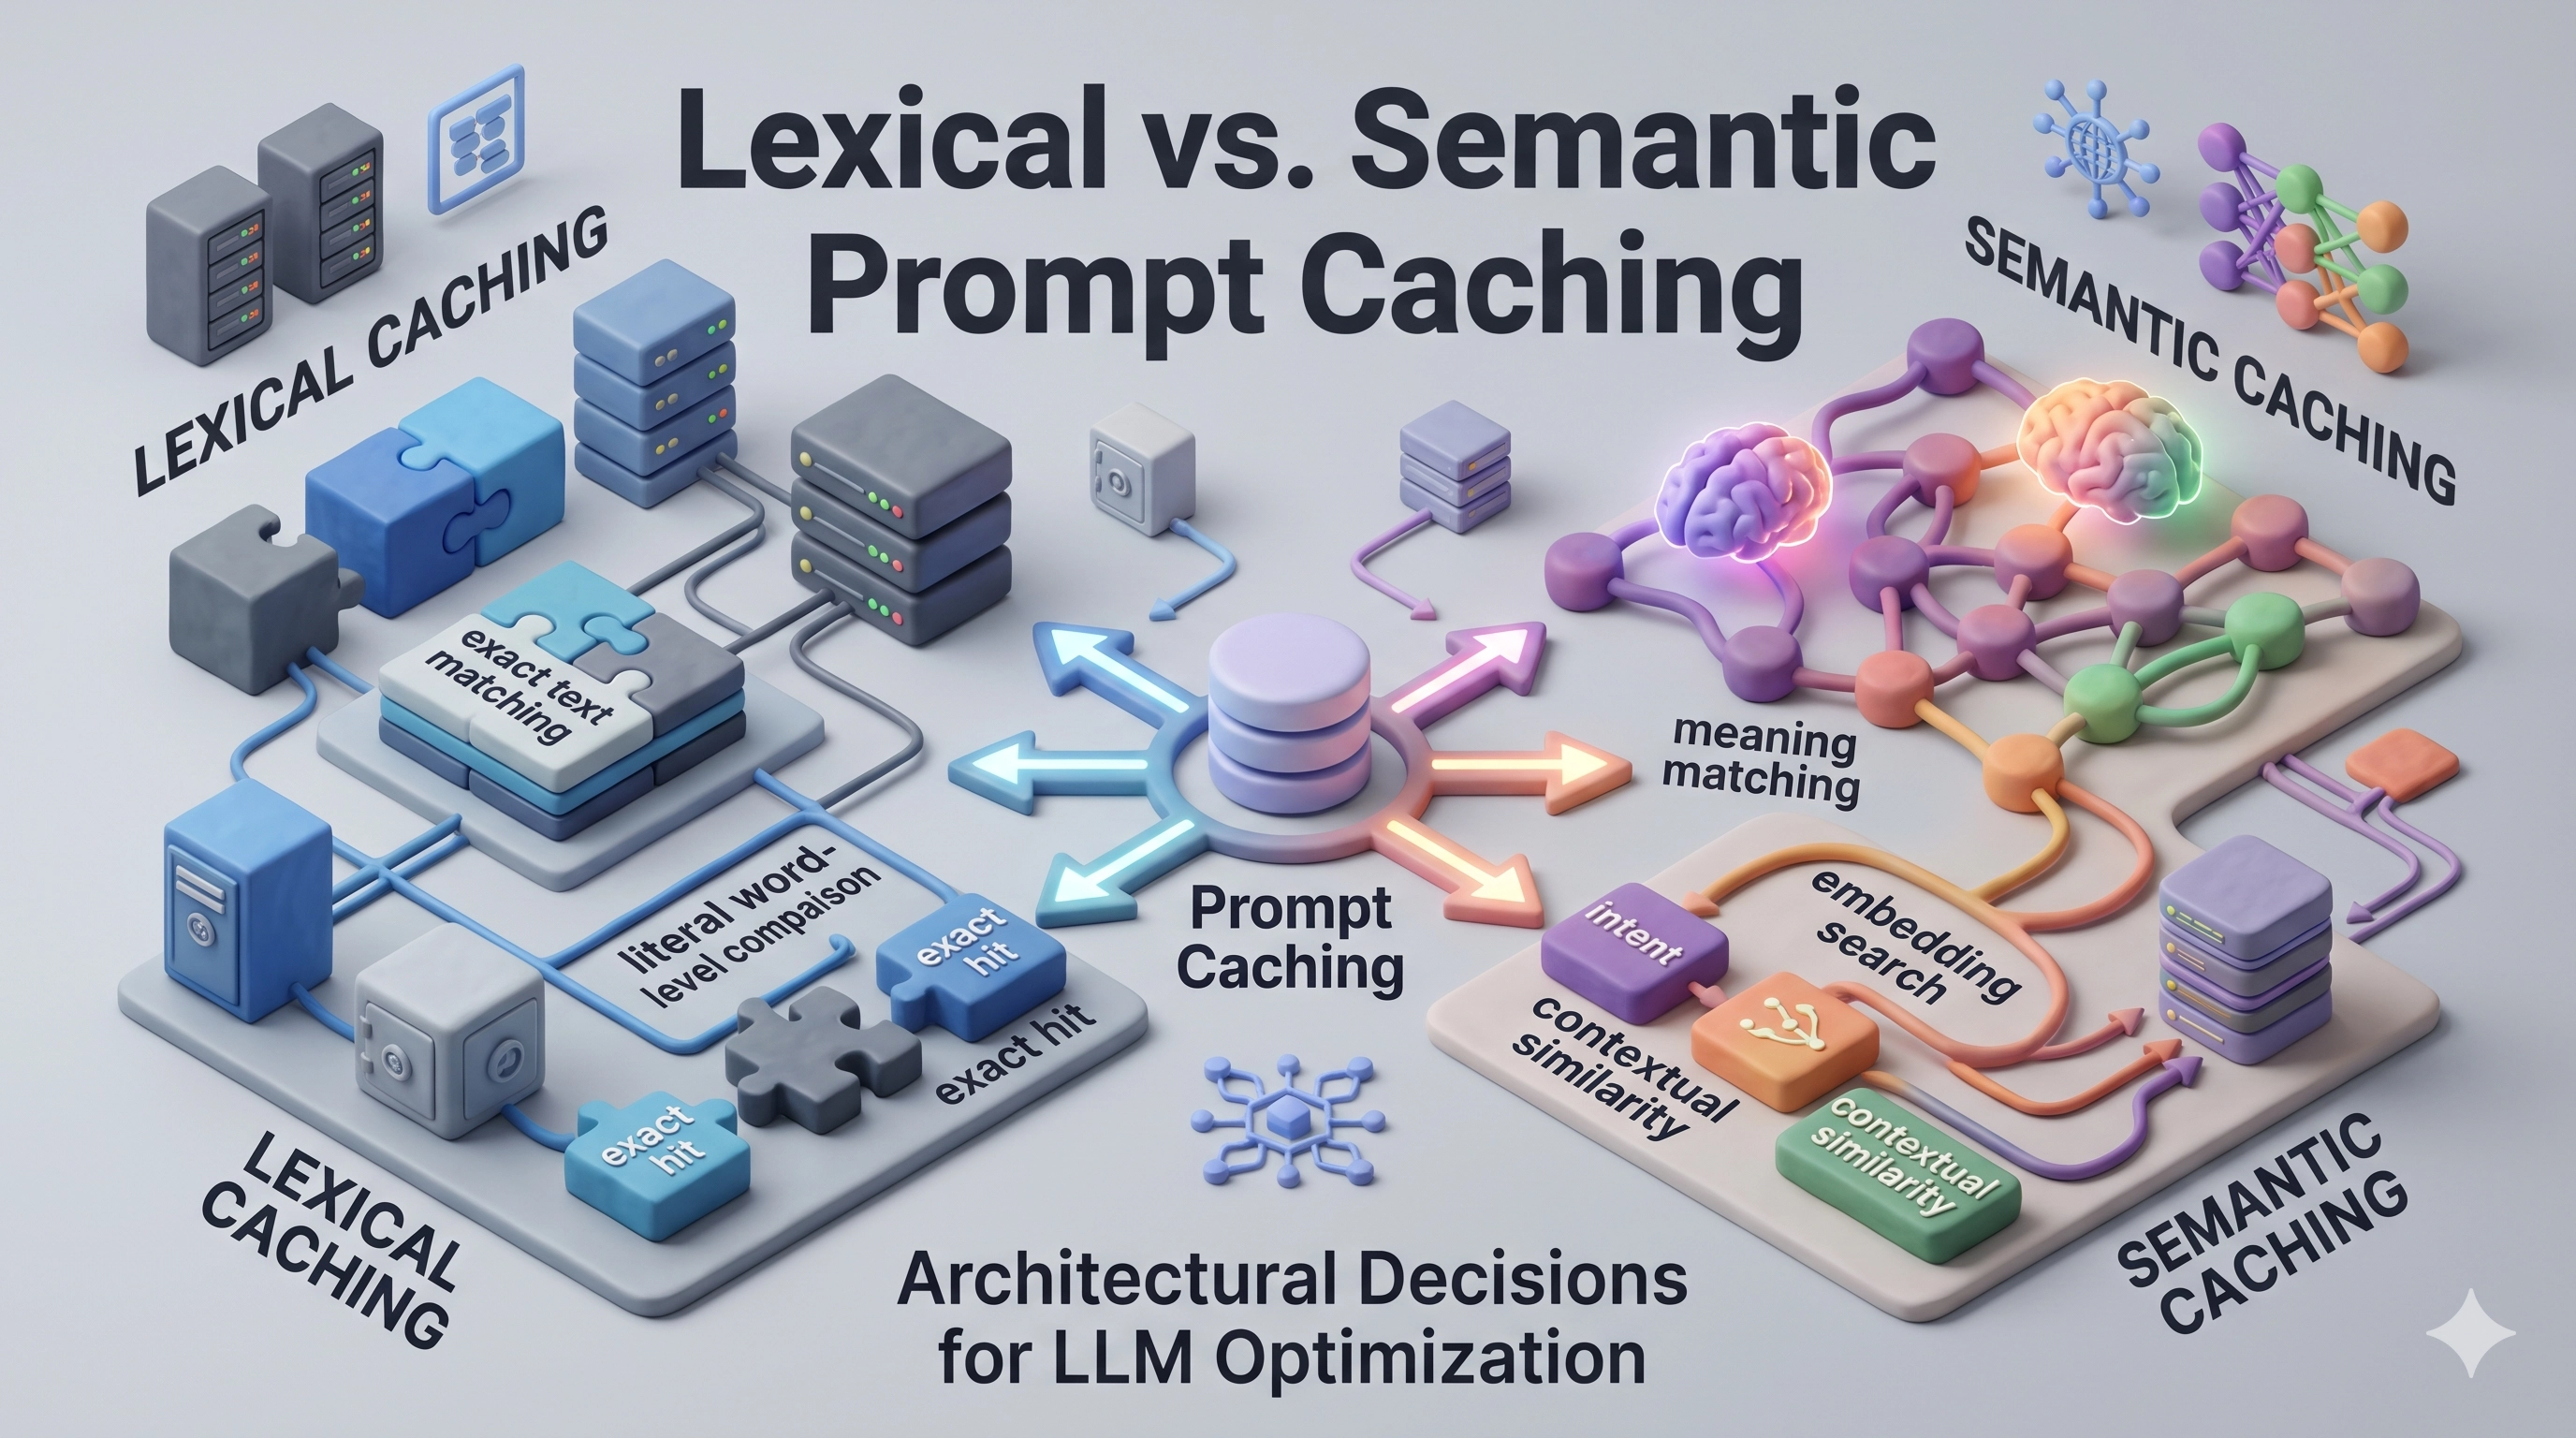
Cache Prompt Từ Vựng so với Cache Prompt Ngữ Nghĩa: Quyết Định Kiến Trúc để Tối Ưu LLM
Trong bối cảnh Large Language Models (LLMs) đang phát triển nhanh chóng, việc tối ưu hóa cả chi phí và độ trễ là vô cùng quan trọng đối với bất kỳ ứng dụng sản xuất nào. Mỗi lệnh gọi API đến nhà cung cấp LLM hoặc suy luận trên mô hình tự lưu trữ đều phát sinh chi phí tính toán và góp phần vào thời gian phản hồi. Một trong những chiến lược hiệu quả nhất để giảm thiểu các yếu tố này là cache prompt.
Mặc dù nhiều framework LLM và thậm chí bản thân các mô hình cũng triển khai các cơ chế cache nội bộ (như chia sẻ tiền tố KV cache), bài viết này tập trung vào các chiến lược cache prompt cấp ứng dụng. Chúng ta sẽ so sánh hai mẫu kiến trúc khác biệt: Cache Prompt Từ Vựng (Lexical Prompt Caching - LPC) và Cache Prompt Ngữ Nghĩa (Semantic Prompt Caching - SPC). Hiểu rõ cơ chế, đánh đổi và trường hợp sử dụng lý tưởng của chúng là rất quan trọng để xây dựng các ứng dụng dựa trên LLM hiệu quả và có khả năng mở rộng.
Cache Prompt Từ Vựng (LPC): Chiến Lược Đối Sánh Chính Xác
Cache Prompt Từ Vựng, về cơ bản, là một cơ chế cache khóa-giá trị đơn giản. "Khóa" là nội dung chuỗi chính xác của prompt người dùng (hoặc một phiên bản đã được chuẩn hóa), và "giá trị" là phản hồi LLM tương ứng. Khi một prompt mới đến, hệ thống trước tiên kiểm tra xem có prompt nào giống hệt trong cache hay không. Nếu tìm thấy, phản hồi đã được cache sẽ được trả về ngay lập tức, bỏ qua hoàn toàn bước suy luận của LLM.
Cơ Chế:
- Chuẩn hóa prompt đầu vào (ví dụ: cắt khoảng trắng, chuyển thành chữ thường).
- Sử dụng prompt đã chuẩn hóa làm khóa để truy vấn một kho cache (ví dụ: Redis, Memcached, một hash map đơn giản trong bộ nhớ).
- Nếu có hit, trả về phản hồi LLM đã được cache.
- Nếu miss, gọi LLM, nhận phản hồi, lưu cặp prompt-phản hồi vào cache, sau đó trả về phản hồi.
Ưu Điểm:
- Đơn Giản: Dễ dàng triển khai với các công nghệ cache tiêu chuẩn.
- Tốc Độ: Tra cứu cực nhanh, thường là O(1) hoặc O(log N) tùy thuộc vào backend cache.
- Tiết Kiệm Có Thể Dự Đoán: Đảm bảo giảm chi phí và độ trễ cho các prompt lặp lại giống hệt nhau.
Nhược Điểm:
- Dễ Vỡ: Ngay cả một thay đổi nhỏ (ví dụ: lỗi chính tả, dấu câu khác) cũng sẽ dẫn đến cache miss.
- Phạm Vi Hạn Chế: Chỉ hiệu quả cho các truy vấn lặp lại nghiêm ngặt. Ít hữu ích hơn cho AI đàm thoại hoặc các đầu vào đa dạng của người dùng.
- Tỷ Lệ Hit Thấp: Đối với nhiều ứng dụng, khả năng lặp lại một prompt chính xác là thấp, dẫn đến tỷ lệ cache hit giảm.
Ví Dụ Triển Khai (Python Khái Niệm):
import redis

def get_llm_response_lpc(prompt: str, llm_api_call_func, cache_client: redis.Redis):
    normalized_prompt = prompt.strip().lower() # Chuẩn hóa đơn giản
    cached_response = cache_client.get(normalized_prompt)

    if cached_response:
        print("LPC Cache Hit!")
        return cached_response.decode('utf-8')
    else:
        print("LPC Cache Miss. Calling LLM...")
        llm_response = llm_api_call_func(prompt)
        cache_client.set(normalized_prompt, llm_response, ex=3600) # Cache trong 1 giờ
        return llm_response
Cache Prompt Ngữ Nghĩa (SPC): Chiến Lược "Dựa Trên Ý Nghĩa"
Cache Prompt Ngữ Nghĩa áp dụng một cách tiếp cận tinh vi hơn, tận dụng sức mạnh của các vector embedding. Thay vì cache prompt dựa trên dạng chuỗi chính xác của chúng, SPC cache chúng dựa trên *ý nghĩa* hoặc *sự tương đồng ngữ nghĩa* của chúng. Khi một prompt đến, nó được chuyển đổi thành một vector embedding, sau đó một tìm kiếm tương đồng được thực hiện trên một cơ sở dữ liệu vector chứa các prompt đã được embedding và cache trước đó. Nếu một prompt đủ tương đồng được tìm thấy (vượt quá ngưỡng tương đồng đã xác định), phản hồi tương ứng của nó sẽ được trả về.
Cơ Chế:
- Chuyển đổi prompt đầu vào thành một vector embedding đa chiều bằng cách sử dụng một mô hình embedding (ví dụ:
text-embedding-ada-002của OpenAI, Sentence Transformers). - Thực hiện tìm kiếm tương đồng (ví dụ: độ tương đồng cosine) trong một cơ sở dữ liệu vector chứa các embedding của các prompt đã được cache trước đó.
- Nếu embedding của một prompt tương đồng được tìm thấy vượt quá ngưỡng tương đồng nhất định, trả về phản hồi LLM liên quan của nó.
- Nếu không tìm thấy prompt nào đủ tương đồng, gọi LLM, nhận phản hồi, embedding prompt mới, lưu cả embedding mới và phản hồi của nó vào cơ sở dữ liệu vector, sau đó trả về phản hồi.
Ưu Điểm:
- Mạnh Mẽ: Chịu được các biến thể nhỏ, lỗi chính tả, cách diễn đạt lại và từ đồng nghĩa.
- Tỷ Lệ Hit Cao Hơn: Có thể đạt được tỷ lệ cache hit cao hơn đáng kể, đặc biệt trong các kịch bản đàm thoại hoặc đầu vào đa dạng.
- Phạm Vi Ứng Dụng Rộng Hơn: Phù hợp hơn cho các ứng dụng LLM phức tạp nơi các prompt lặp lại chính xác là hiếm nhưng các truy vấn tương tự về mặt ngữ nghĩa là phổ biến.
Nhược Điểm:
- Phức Tạp: Yêu cầu một mô hình embedding và một cơ sở dữ liệu vector, bổ sung thêm chi phí kiến trúc và độ phức tạp vận hành.
- Chi Phí Độ Trễ: Việc tạo embedding và tìm kiếm tương đồng vector bổ sung độ trễ, có thể làm mất đi một số lợi ích nếu không được quản lý tốt.
- Điều Chỉnh Ngưỡng: Xác định ngưỡng "đủ tương đồng" là rất quan trọng và thường đòi hỏi điều chỉnh cẩn thận để cân bằng giữa sự liên quan và tỷ lệ hit.
- Khả Năng Không Liên Quan: Nếu ngưỡng quá thấp, phản hồi đã cache có thể tương đồng về mặt ngữ nghĩa nhưng không hoàn toàn chính xác, dẫn đến giảm chất lượng tinh tế.
Ví Dụ Triển Khai (Python Khái Niệm):
from qdrant_client import QdrantClient
from qdrant_client.models import PointStruct, VectorParams, Distance
import openai # hoặc thư viện mô hình embedding khác
import uuid # Để tạo ID duy nhất

# Giả sử qdrant_client đã được khởi tạo và collection đã tồn tại
# Giả sử get_embedding_func bao bọc openai.embeddings.create (hoặc tương tự)

def get_llm_response_spc(prompt: str, llm_api_call_func, embed_model_func, vector_db_client: QdrantClient, collection_name: str, similarity_threshold: float = 0.85):
    query_embedding = embed_model_func(prompt)

    search_result = vector_db_client.search(
        collection_name=collection_name,
        query_vector=query_embedding,
        limit=1
    )

    if search_result and search_result[0].score >= similarity_threshold:
        print("SPC Cache Hit!")
        # Giả sử payload lưu trữ prompt gốc và phản hồi
        return search_result[0].payload["llm_response"]
    else:
        print("SPC Cache Miss. Calling LLM...")
        llm_response = llm_api_call_func(prompt)

        # Lưu prompt mới, embedding và phản hồi vào Vector DB
        point = PointStruct(
            id=str(uuid.uuid4()), # Tạo ID duy nhất
            vector=query_embedding,
            payload={"original_prompt": prompt, "llm_response": llm_response}
        )
        vector_db_client.upsert(
            collection_name=collection_name,
            points=[point]
        )
        return llm_response
Lưu ý: Ví dụ client Qdrant đã được đơn giản hóa. Trong một kịch bản thực tế, bạn sẽ quản lý việc tạo collection, kích thước vector và cấu trúc payload mạnh mẽ hơn.
Đánh Đổi Kiến Trúc & Hướng Dẫn Quyết Định
Việc lựa chọn giữa LPC và SPC (hoặc một cách tiếp cận lai) phụ thuộc rất nhiều vào yêu cầu ứng dụng, mô hình lưu lượng truy cập và khả năng chịu đựng độ phức tạp của bạn.
1. Hồ Sơ Chi Phí:
- LPC: Chi phí tính toán tối thiểu ngoài các thao tác chuỗi cơ bản. Chi phí lưu trữ cho khóa/giá trị thường thấp.
- SPC: Phát sinh chi phí cho các lệnh gọi API mô hình embedding (nếu bên ngoài) hoặc suy luận (nếu tự lưu trữ), và các thao tác/lưu trữ cơ sở dữ liệu vector. Những chi phí này có thể đáng kể.
2. Đặc Điểm Độ Trễ:
- LPC: Tra cứu cache gần như tức thì.
- SPC: Bổ sung độ trễ cho việc tạo embedding và tìm kiếm tương đồng vector. Chi phí này có thể chấp nhận được đối với các prompt phức tạp nhưng có thể là nút thắt cổ chai đối với các ứng dụng rất nhanh.
3. Độ Phức Tạp Triển Khai & Vận Hành:
- LPC: Độ phức tạp thấp. Một instance Redis hoặc thậm chí một cache trong bộ nhớ thường là đủ.
- SPC: Độ phức tạp cao. Yêu cầu quản lý một mô hình embedding (khóa API, giới hạn tốc độ hoặc triển khai) và một cơ sở dữ liệu vector (mở rộng, lập chỉ mục, bảo trì).
4. Tỷ Lệ Hit Cache & Mạnh Mẽ:
- LPC: Tỷ lệ hit thấp đến trung bình, rất dễ vỡ. Tốt nhất cho các truy vấn lặp lại, giống hệt nhau.
- SPC: Khả năng có tỷ lệ hit cao, rất mạnh mẽ đối với các biến thể. Lý tưởng cho các ứng dụng có đầu vào người dùng đa dạng nhưng tương tự về mặt ngữ nghĩa.
Khi Nào Nên Chọn Loại Nào:
- Chọn LPC nếu:
- Ứng dụng của bạn chủ yếu xử lý các prompt lặp lại rất nhiều, gần như giống hệt nhau (ví dụ: các lệnh cụ thể, truy vấn có cấu trúc, prompt hệ thống nội bộ).
- Bạn ưu tiên độ trễ cực thấp và chi phí vận hành tối thiểu.
- Việc tiết kiệm chi phí từ các đối sánh chính xác là đủ đáng kể cho trường hợp sử dụng của bạn.
- Chọn SPC nếu:
- Ứng dụng của bạn liên quan đến hiểu ngôn ngữ tự nhiên, AI đàm thoại hoặc các truy vấn của người dùng có sự biến đổi ngôn ngữ đáng kể.
- Bạn cần giảm chi phí và độ trễ ngay cả đối với các prompt tương tự về mặt ngữ nghĩa nhưng không giống hệt nhau.
- Bạn có đủ nguồn lực kỹ thuật để quản lý cơ sở hạ tầng bổ sung (mô hình embedding, cơ sở dữ liệu vector).
- Bạn có thể chấp nhận một chút tăng độ trễ cho việc tra cứu cache do việc tạo embedding và tìm kiếm vector.
- Cân nhắc Cách Tiếp Cận Lai:
- Đầu tiên, thử tra cứu LPC. Nếu miss, sau đó thực hiện tra cứu SPC.
- Chiến lược này kết hợp tốc độ của LPC cho các đối sánh chính xác với sự mạnh mẽ của SPC cho sự tương đồng ngữ nghĩa, mang lại một cách tiếp cận cân bằng.
Bài Học Sản Xuất & Các Chế Độ Thất Bại
Triển khai cache prompt hiệu quả đòi hỏi phải xem xét cẩn thận một số yếu tố:
- Vô Hiệu Hóa Cache: Các LLM liên tục phát triển và phản hồi của chúng có thể thay đổi theo thời gian, làm cho dữ liệu đã cache trở nên lỗi thời. Triển khai các chính sách TTL (Time-To-Live) mạnh mẽ hoặc cơ chế vô hiệu hóa thủ công.
- Quản Lý Cửa Sổ Ngữ Cảnh: Đối với các ngữ cảnh hội thoại dài, việc cache toàn bộ cuộc trao đổi có thể phức tạp. Cân nhắc cache từng lượt hoặc ngữ cảnh tóm tắt.
- Tính Nhạy Cảm & Quyền Riêng Tư: Cẩn thận khi cache các prompt hoặc phản hồi chứa dữ liệu nhạy cảm của người dùng. Triển khai ẩn danh phù hợp hoặc tránh cache các tương tác đó.
- Giám Sát: Theo dõi tỷ lệ cache hit, độ trễ và tiết kiệm chi phí cho cả LPC và SPC để hiểu tác động thực tế của chúng và tinh chỉnh các thông số.
- Lệch Mô Hình Embedding (đối với SPC): Nếu bạn cập nhật mô hình embedding của mình, các embedding đã được cache hiện có có thể trở nên không tương thích hoặc kém hiệu quả, có khả năng yêu cầu xây dựng lại cache.
Điểm Cốt Lõi
- Cache Prompt Từ Vựng đơn giản, nhanh chóng và tiết kiệm chi phí cho các prompt lặp lại chính xác, mang lại khoản tiết kiệm có thể dự đoán được nhưng thiếu mạnh mẽ đối với các biến thể.
- Cache Prompt Ngữ Nghĩa phức tạp hơn và bổ sung độ trễ, nhưng cung cấp tỷ lệ hit và sự mạnh mẽ vượt trội cho các truy vấn ngôn ngữ tự nhiên bằng cách tận dụng sự tương đồng vector.
- Sự lựa chọn phụ thuộc vào các mẫu prompt cụ thể của ứng dụng, yêu cầu hiệu suất và nguồn lực kỹ thuật của bạn. Một chiến lược lai thường mang lại điều tốt nhất của cả hai thế giới.
Hãy là người đầu tiên bình luận.
Để lại bình luận