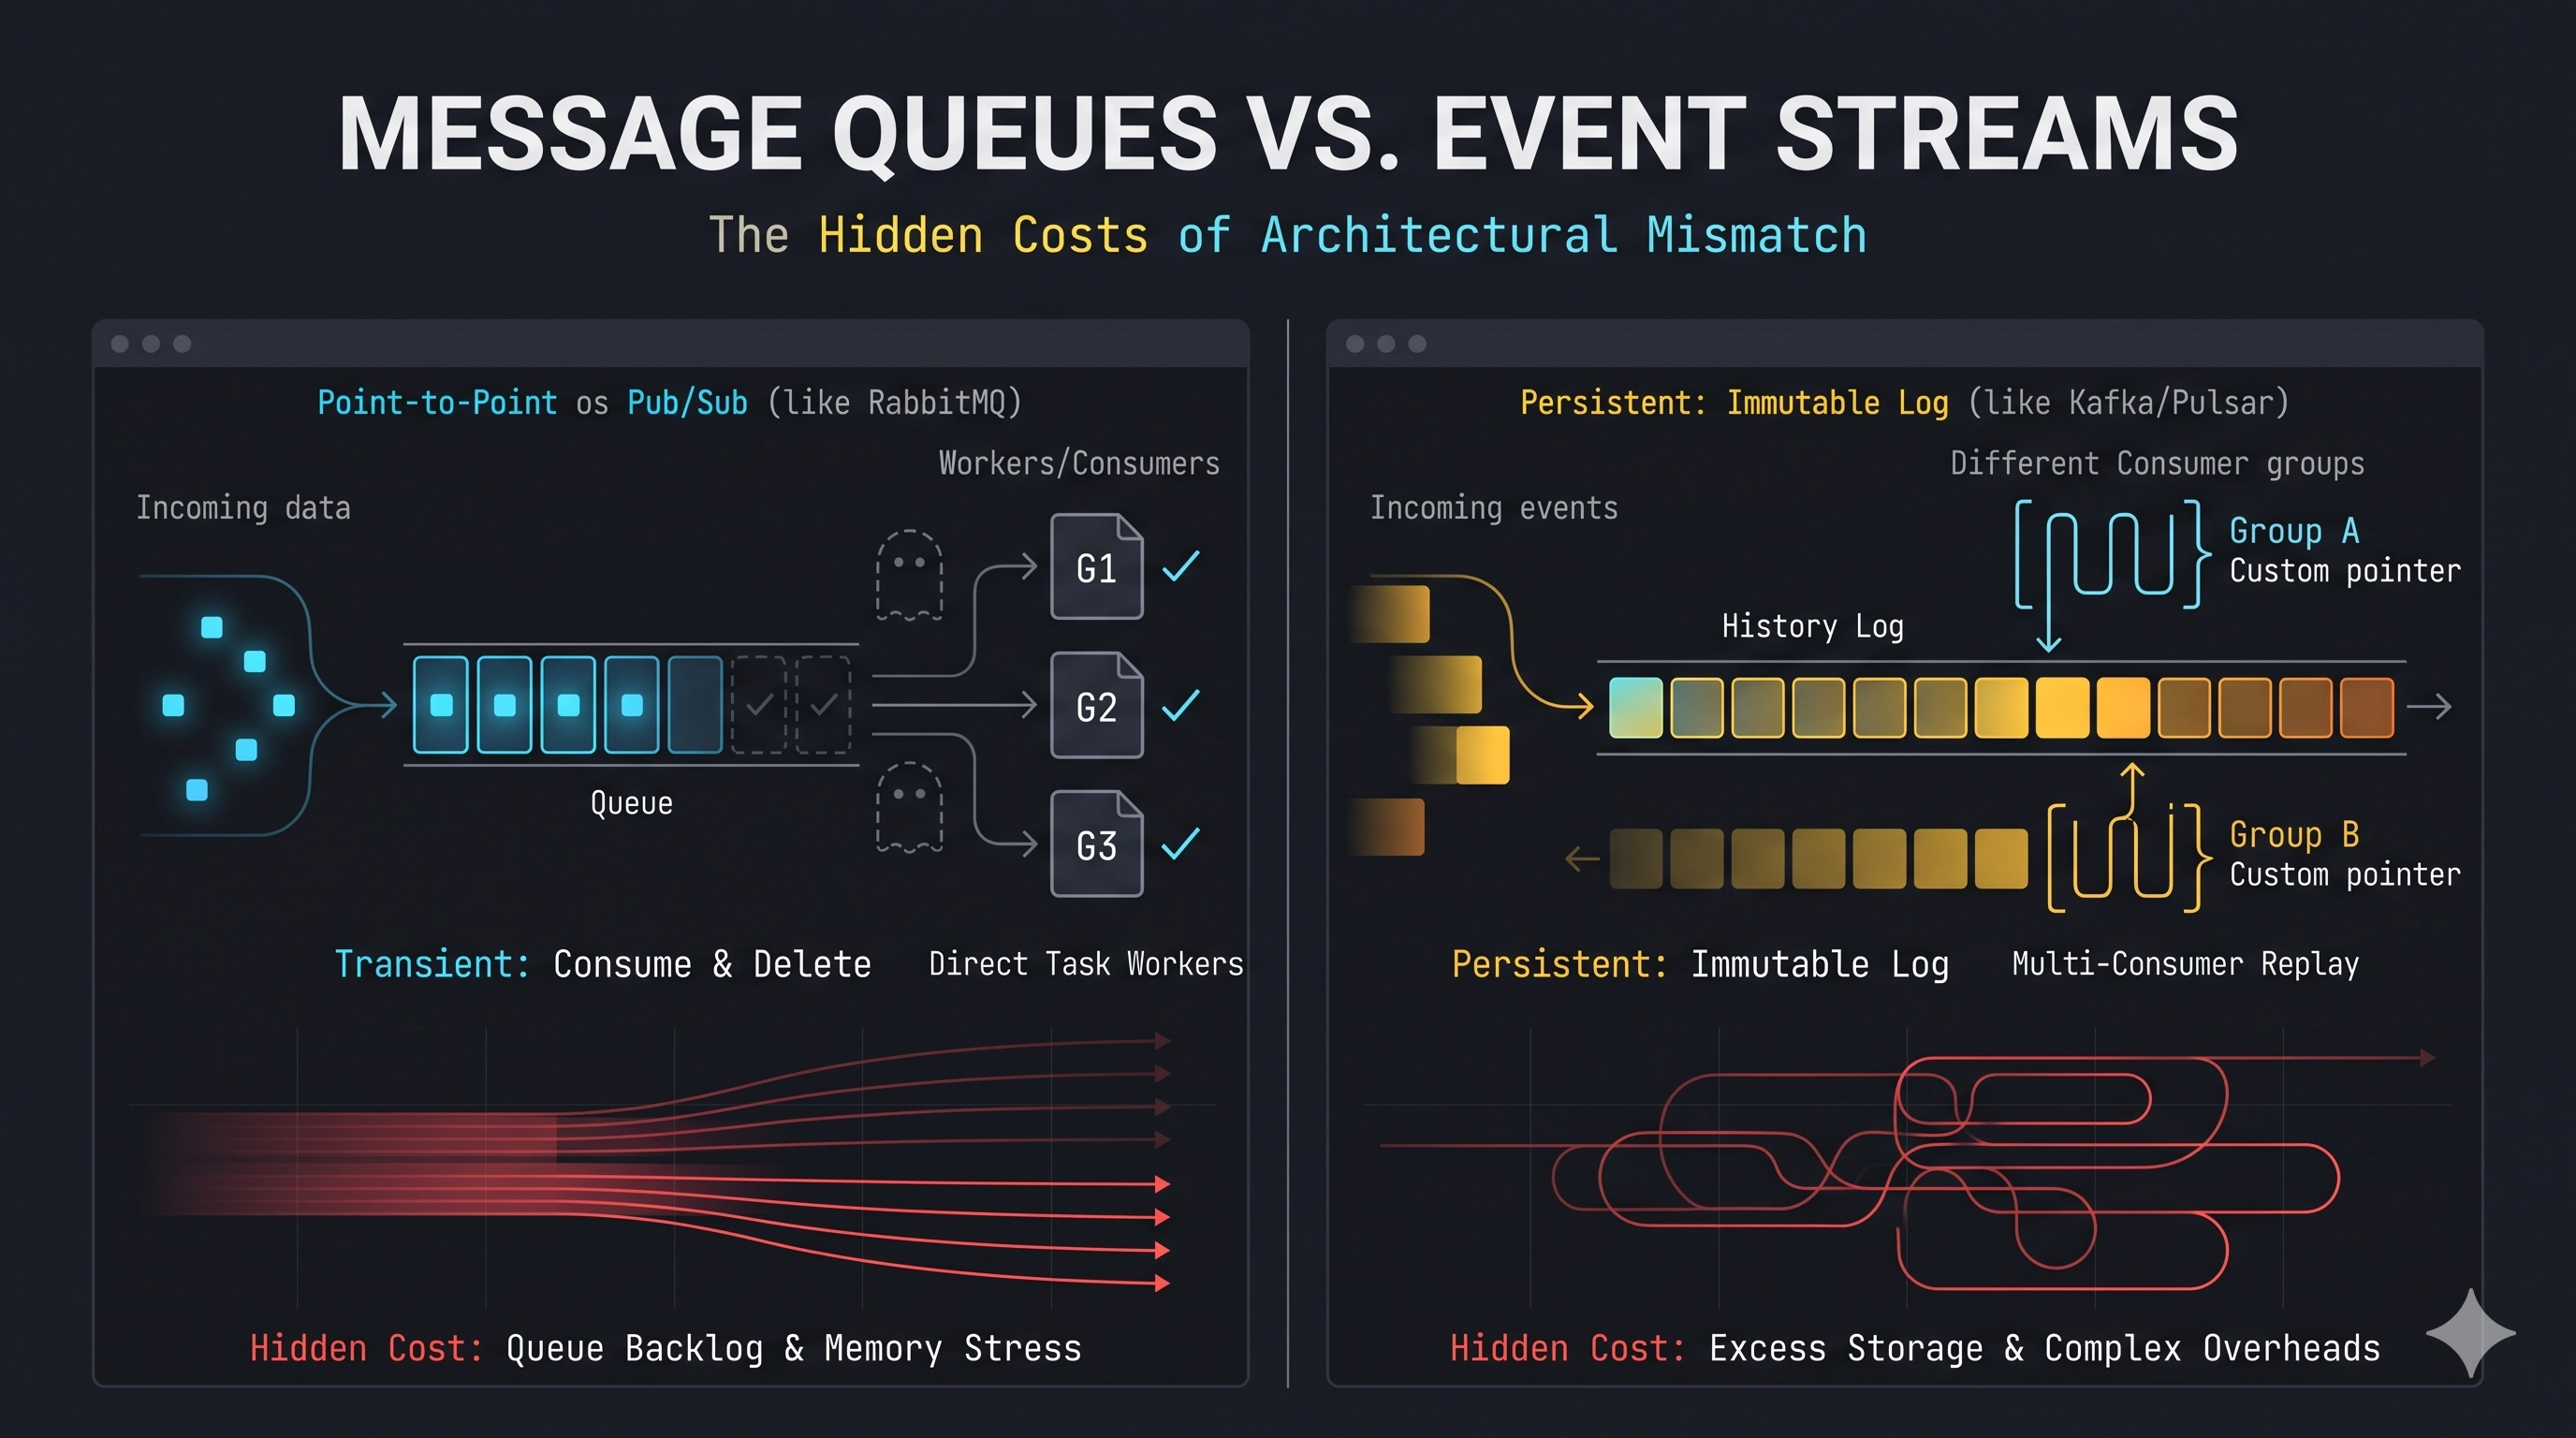
Các nhà phát triển thường cần gửi dữ liệu giữa các dịch vụ một cách bất đồng bộ. Điều này ngay lập tức khiến họ nghĩ đến các hệ thống hàng đợi thông điệp. Nhưng mặc dù các thuật ngữ như "hàng đợi thông điệp" (message queue) và "luồng sự kiện" (event stream) đôi khi được sử dụng thay thế cho nhau, kiến trúc nền tảng của các hệ thống như RabbitMQ và Apache Kafka lại khác biệt sâu sắc. Coi chúng chỉ là những từ đồng nghĩa là một cạm bẫy phổ biến dẫn đến các vấn đề sản xuất tinh vi nhưng gây đau đầu: mất thông điệp, khả năng phát lại phức tạp, tăng độ trễ bất ngờ, hoặc không thể mở rộng theo các mẫu nhất định.
Bài viết này sẽ đi sâu vào những điểm khác biệt cốt lõi đó, làm nổi bật cách một sự sai lệch kiến trúc – chọn sai công cụ cho công việc – có thể biểu hiện thành các lỗi đau đớn và nút thắt cổ chai về hiệu suất trong hệ thống backend của bạn.
Hiểu Rõ Sự Khác Biệt Cốt Lõi
Ở cấp độ cao, cả hàng đợi thông điệp và luồng sự kiện đều hỗ trợ giao tiếp bất đồng bộ. Tuy nhiên, ngữ nghĩa cơ bản, mô hình lưu giữ dữ liệu và các mẫu mở rộng của chúng lại khác nhau đáng kể.
Hàng Đợi Thông Điệp (Ví dụ: RabbitMQ)
Hàng đợi thông điệp được thiết kế cho giao tiếp điểm-tới-điểm và phân phối tác vụ tạm thời. Hãy hình dung chúng như một danh sách việc cần làm mà các worker sẽ nhận và xử lý.
- Ngữ nghĩa: Thông điệp thường được gửi đến một consumer duy nhất, và một khi được xác nhận, chúng sẽ bị xóa khỏi hàng đợi. Đây là mô hình "đọc phá hủy" (destructive read).
- Kiến trúc: Tập trung vào broker. Broker (như RabbitMQ) là "thông minh", quản lý việc định tuyến thông điệp, duy trì (cho đến khi được consumer xử lý), và đảm bảo phân phối. Các consumer tương đối "ngu ngốc" – chúng chỉ nhận và xử lý.
- Mô hình dữ liệu: Thông điệp tạm thời. Thông điệp có vòng đời giới hạn và không được thiết kế để lưu trữ lâu dài hoặc phát lại.
- Thứ tự: Thường là FIFO (First-In, First-Out) trên mỗi hàng đợi, nhưng việc phân phối thông điệp qua nhiều hàng đợi hoặc consumer có thể làm phức tạp thứ tự toàn cục.
Khi RabbitMQ Nổi Trội:
- Giải phóng Tác vụ: Xử lý bất đồng bộ các công việc nền (ví dụ: thay đổi kích thước ảnh, gửi email).
- Cân bằng Tải: Đệm các đợt tăng đột biến trong yêu cầu để làm mượt tải trên các dịch vụ backend.
- Tách Biệt Dịch Vụ: Cho phép các dịch vụ giao tiếp mà không cần biết trực tiếp về nhau, nơi thông điệp được consumer xử lý một lần.
Ví dụ: Hàng đợi tác vụ đơn giản (Khái niệm Node.js/RabbitMQ)
// Producer
channel.sendToQueue('image_processing_queue', Buffer.from(imagePath), { persistent: true });

// Consumer
channel.consume('image_processing_queue', async (msg) => {
  if (msg !== null) {
    console.log(`Processing image: ${msg.content.toString()}`);
    await processImage(msg.content.toString());
    channel.ack(msg); // Thông điệp bị xóa khỏi hàng đợi
  }
}, { noAck: false });
Luồng Sự Kiện (Ví dụ: Apache Kafka)
Luồng sự kiện được xây dựng cho các mẫu publish-subscribe và các nhật ký sự kiện bền vững, bất biến. Hãy hình dung chúng như một sổ cái liên tục, chỉ ghi thêm vào, ghi lại mọi thứ đã xảy ra.
- Ngữ nghĩa: Các sự kiện được thêm vào một nhật ký và có sẵn cho nhiều consumer độc lập. Các consumer theo dõi "offset" (vị trí trong nhật ký) của riêng chúng. Các sự kiện được giữ lại trong một khoảng thời gian cấu hình, không bị xóa khi được consumer xử lý. Đây là mô hình "đọc không phá hủy" (non-destructive read).
- Kiến trúc: Nhật ký phân tán. Broker (Kafka) tương đối "ngu ngốc" – nó chỉ lưu trữ và phục vụ các bản ghi sự kiện. Các consumer "thông minh", quản lý tiến độ tiêu thụ của riêng chúng (offset) và cho phép khả năng phát lại mạnh mẽ.
- Mô hình dữ liệu: Các sự kiện bất biến, bền vững. Các sự kiện tạo thành một bản ghi lịch sử có thể được phát lại từ bất kỳ điểm nào.
- Thứ tự: Đảm bảo FIFO trong một partition duy nhất. Thứ tự toàn cục yêu cầu thiết kế cẩn thận bằng cách sử dụng một partition duy nhất hoặc sắp xếp lại ở cấp độ consumer.
Khi Kafka Nổi Trội:
- Event Sourcing: Xây dựng lại trạng thái ứng dụng từ một chuỗi các sự kiện bất biến.
- Phân tích & Pipeline Dữ liệu Thời gian thực: Xử lý khối lượng lớn sự kiện cho các dashboard, giám sát hoặc đưa dữ liệu vào các data lake.
- Change Data Capture (CDC): Ghi lại các thay đổi cơ sở dữ liệu dưới dạng một luồng sự kiện.
- Phát sóng Sự kiện: Gửi cùng một sự kiện một cách đáng tin cậy đến nhiều dịch vụ độc lập.
Ví dụ: Luồng Sự Kiện (Khái niệm Python/Kafka)
# Producer
producer.send('user_activity_stream', key=b'user123', value=b'{"action": "login"}')
producer.flush()

# Consumer (trong một consumer group)
for message in consumer:
  print(f"Topic: {message.topic}, Partition: {message.partition}, Offset: {message.offset}, Key: {message.key}, Value: {message.value.decode('utf-8')}")
  # Kafka tự động quản lý offset của consumer cho group
Những Cạm Bẫy Sản Xuất: Cái Giá Của Sai Lệch Kiến Trúc
Chọn sai hệ thống thông điệp không chỉ là một sai lầm lý thuyết; nó dẫn đến các vấn đề sản xuất cụ thể, gây đau đầu.
Cạm Bẫy 1: Cố gắng Phát lại Sự kiện với Hàng đợi Thông điệp
Triệu chứng: Một microservice mới cần xử lý tất cả các sự kiện đăng ký người dùng trong quá khứ, nhưng hệ thống hiện tại của bạn sử dụng RabbitMQ cho các đăng ký người dùng. Bạn nhận ra không có cách nào để lấy các sự kiện cũ mà không cần thiết kế lại toàn bộ luồng đăng ký và chèn lại dữ liệu.
Nguyên nhân gốc rễ: Hàng đợi thông điệp vốn dĩ sẽ xóa thông điệp sau khi consumer xử lý thành công. Chúng không được thiết kế để lưu trữ nhật ký lịch sử của các sự kiện. Nếu một dịch vụ mới đi vào hoạt động hoặc một dịch vụ hiện có cần xử lý lại dữ liệu, các sự kiện đơn giản là đã biến mất.
Giải pháp cấp độ sản xuất: Đối với các kiến trúc hướng sự kiện yêu cầu khả năng phát lại, kiểm toán hoặc nhiều consumer độc lập của cùng một luồng sự kiện, Kafka (hoặc các nền tảng luồng sự kiện tương tự) là lựa chọn đúng đắn. Nó coi các sự kiện như một nhật ký bất biến, cho phép các consumer bắt đầu từ bất kỳ offset nào và xử lý lại dữ liệu.
Cạm Bẫy 2: Thiết kế Quá mức cho Phân phối Tác vụ Đơn giản bằng Luồng Sự kiện
Triệu chứng: Bạn sử dụng Kafka cho tất cả các tác vụ bất đồng bộ. Đối với các công việc nền đơn giản như gửi một email duy nhất, bạn thấy mình phải đối phó với consumer group, quản lý offset và khóa partition của Kafka, điều này cảm thấy quá phức tạp. Bạn thậm chí có thể thấy thông điệp nằm trong nhật ký lâu hơn mức cần thiết, tiêu tốn không gian đĩa.
Nguyên nhân gốc rễ: Mặc dù Kafka có thể được sử dụng cho hàng đợi tác vụ, thế mạnh của nó nằm ở việc xử lý luồng và nhật ký sự kiện bền vững. Đối với các mẫu "fire-and-forget" đơn giản hoặc phân phối công việc nơi một thông điệp được xử lý một lần và sau đó bị loại bỏ, chi phí quản lý nhật ký bền vững và consumer group phân tán của Kafka có thể là sự phức tạp không cần thiết. Hơn nữa, việc đảm bảo FIFO nghiêm ngặt cho một loại tác vụ cụ thể trên nhiều partition Kafka đòi hỏi việc phân khóa cẩn thận, điều này có thể không trực quan hoặc đơn giản.
Giải pháp cấp độ sản xuất: Đối với các hàng đợi tác vụ tạm thời, đơn giản, đặc biệt là những tác vụ cần FIFO nghiêm ngặt cho một nhóm worker cụ thể và không quan tâm đến khả năng phát lại, một hàng đợi thông điệp chuyên dụng như RabbitMQ thường là lựa chọn đơn giản, hiệu quả và nhẹ nhàng hơn về mặt vận hành.
Cạm Bẫy 3: Độ Trễ Không Tối ưu cho Giao tiếp Điểm-tới-Điểm
Triệu chứng: Hệ thống của bạn yêu cầu các thông điệp lệnh điểm-tới-điểm có độ trễ thấp (ví dụ: kích hoạt một hành động cụ thể trên một thiết bị). Bạn triển khai điều này bằng Kafka, nhưng bất chấp nỗ lực, độ trễ từ đầu đến cuối cao hơn dự kiến, và bạn đang gặp khó khăn trong việc đảm bảo phân phối đến một người nhận cụ thể, duy nhất mà không cần thiết kế topic phức tạp.
Nguyên nhân gốc rễ: Kafka được tối ưu hóa cho việc xử lý hàng loạt và luồng có thông lượng cao, điều này có thể gây ra độ trễ nhỏ khi thông điệp được đệm và ghi vào đĩa trước khi có sẵn cho consumer. Mặc dù có thể triển khai Kafka với độ trễ thấp, RabbitMQ, với cơ chế hàng đợi trực tiếp và các tối ưu hóa trong bộ nhớ (đối với thông điệp không bền vững), thường có thể cung cấp độ trễ thấp hơn cho các mẫu lệnh điểm-tới-điểm cụ thể mà việc tiêu thụ ngay lập tức bởi một trình xử lý duy nhất là tối quan trọng. Đảm bảo phân phối cho một người nhận duy nhất trong Kafka yêu cầu sử dụng cẩn thận consumer group, phân vùng và có thể là các topic riêng lẻ cho mỗi người nhận, làm tăng sự phức tạp.
Giải pháp cấp độ sản xuất: Đánh giá xem liệu một mẫu "command bus" thực sự (điểm-tới-điểm, một consumer, thường là xác nhận đồng bộ hoặc gần đồng bộ) có phù hợp hơn cho các hành động quan trọng, độ trễ thấp hay không. Đối với các trường hợp như vậy, một hàng đợi thông điệp truyền thống hoặc thậm chí một lệnh gọi RPC trực tiếp có thể phù hợp hơn, hoặc một cách tiếp cận lai trong đó Kafka xử lý luồng sự kiện và RabbitMQ xử lý các lệnh cụ thể.
Điểm Cốt Lõi
- Hàng Đợi Thông Điệp (RabbitMQ): Lý tưởng cho phân phối tác vụ tạm thời, hàng đợi công việc và các kịch bản mà thông điệp được xử lý một lần và xóa đi. Chúng cung cấp khả năng mở rộng đơn giản hơn cho các nhóm worker cụ thể và thường có độ trễ thấp hơn cho các lệnh điểm-tới-điểm.
- Luồng Sự Kiện (Kafka): Cần thiết cho các nhật ký sự kiện bền vững, event sourcing, các pipeline dữ liệu thời gian thực và phát sóng sự kiện đến nhiều consumer độc lập. Chúng cung cấp khả năng phát lại và được xây dựng cho việc xử lý luồng có thông lượng cao, chịu lỗi.
- Chọn Lựa Khôn Ngoan: Điểm khác biệt chính là liệu bạn cần một tác vụ tạm thời hay một sự kiện bất biến, có thể phát lại. Sự sai lệch kiến trúc dẫn đến tăng độ phức tạp, các nút thắt cổ chai về hiệu suất và những hạn chế khó giải quyết sau khi triển khai. Đừng cố gắng ép buộc một công cụ vào miền chính của công cụ kia; hãy hiểu triết lý cơ bản của hệ thống thông điệp của bạn.
Hãy là người đầu tiên bình luận.
Để lại bình luận